lunes, 18 de agosto de 2014

El Phubbing, un gran problema

Antes que nada vamos a definir que es el Phubbing para aquellos que desconocen la palabra pero de seguro que lo han visto en acción.

Phubbing  
Es el acto de utilizar teléfonos inteligentes (smartphones), ignorando completamente su entorno (presencia de otras personas). Este termino aparece en el año 2007 con el nacimiento de dichos aparatitos.

El término se originó en Australia, producto de la unión de las palabras phone (teléfono) y snubbing (despreciar).

Generalizando la palabra Phubbing se puede llevar a cualquier utilización de tecnología móvil como tables, portátiles, etc. Ignorando tu entorno.

Ya habiendo explicado la palabra "Phubbing", pasamos al motivo de este post.

¿El Phubbing es un problema?
La respuesta inmediata es "SI". El acto de concentración y utilización de los dispositivos móviles, eliminando el entorno trae definitivamente serios problemas con uno mismo y con los que te rodean. Además uno se vuelve descortés con aquellos que te acompañan.

Las imágenes valen más que mil palabras:


¿Lo han visto?, ¿les ha pasado?

Yo lo veo cada vez que salgo con mi esposa a comer o caminar, cuando salgo con mis hijos a jugar o pasear. Siempre lo comparo con una gripe, es un mal hábito que lo adquieres sin saber como y que poco a poco puede llegar a ser crónico, o como otros lo dicen adictivo, sobre todo en los niños, adolescentes y jóvenes.

Aquí un vídeo como ejemplo:


Nos podemos dar cuenta sin lugar a dudas que los adolescentes y jóvenes de hoy prefieren el contacto por redes sociales y no cara a cara y nosotros los padres no les impedimos esto.

Hoy en día les compramos los teléfonos de última generación a nuestros hijos y lo que estamos haciendo no es más que alejarlos de nosotros. Vaya que problema del cual no será tan fácil salir airosos

Problemas generados por el Phubbing

- Daño en las relaciones humanas (quedan rotas o mermadas)
- Aumenta el nivel de estrés (siguen buscando más datos, nuevos mensajes y nuevas actualizaciones)
- Paran más ocupados de los teléfonos que de una buena comida o de la compañía de alguien.
- En algunos casos una persona que tiene la adicción del phubbing, pasa por las mismas fases que generan las adicciones a la nicotina: síndrome de abstinencia, miedo, constante pensamiento en el dispositivo e incluso dolores de cabeza, mareos y náuseas (doctor mexicano Cuauhtémoc Borges Aguilar).

Espero recapacitemos y les dejo otro vídeo el cual espero les ayude a reflexionar y tomar adecuadas decisiones para con los suyos.


Hasta la próxima su amigo Carlos Z.

jueves, 7 de noviembre de 2013

AJAX, jQUERY con PHP

Existe una parte del mercado que desea agregar mayor funcionalidad a sus aplicaciones Web por medio del cliente Web pero sin necesidad de usar Flash, Applets de Java, entre otras tecnologías.

Normalmente los desarrolladores han venido trabajando aplicaciones Web utilizando HTML, JavaScript y PHP (o alguna tecnología de servidor similar como JAVA, c#, etc.)

El problema a lo mencionado anteriormente es que los clientes necesitan datos nuevos del servidor y para esto se deben solicitar y recargar nuestra página interrumpiendo la actividad del usuario. El recargar la página es un problema en la actualidad y aquí entra a tallar AJAX o jQUERY.

NOTA: Empezaré hablando de AJAX, por así decirlo es la tecnología que arranca esto.

AJAX

Tecnologías que conforman AJAX
Las tecnologías que conforman AJAX están ya implementadas en todos los navegadores modernos como: Mozilla Firefox, Internet Explorer, Opera, Chrome. Así que no es necesario instalar ningún módulo extra en el cliente para ejecutar un sitio Web con AJAX.


Ahora describiré cada una:

JavaScript: Las aplicaciones AJAX se se deben escribir con este lenguaje de programación por lo que es la tecnología esencial de AJAX que permite dotar de funcionalidades al cliente. Se hará uso intensivo del DOM para manipular partes de la página. 

Document Object Model (DOM): es esencialmente una interfaz de programación de aplicaciones para acceder, añadir y cambiar dinámicamente contenido estructurado en documentos HTML y XML con JavaScript.

El objeto XMLHttpRequest: Permite acceder al servidor de manera asíncrona mediante JavaScript de manera que el usuario puede seguir trabajando mientras la acción se realiza en segundo plano.

XML: Es el tipo de documento utilizado generalmente por la aplicación del lado del servidor usada principalmente para enviar una serie de datos de forma estructurada al cliente.

HTML y CSS: La primera tecnología se basa en la utilización de marcas para construir páginas Web y la segunda se encarga de mejorar la presentación.


Comunicación Cliente-Servidor
El script en el cliente que accede al servidor (utilizando el objeto XMLHttpRequest) puede utilizar parejas nombre-valor utilizando GET o POST.

El servidor haciendo uso de una tecnología de servidor (J2EE, ASP.NET o PHP) envía de vuelta la respuesta vía HTTP. Esta respuesta estará en un formato que será interpretado por el código JavaScript del cliente. Los formatos recomendados son XML o Texto.


Ejemplo

HTML


JavaScript y AJAX (archivo funciones.js)


Lenguaje de servidor- PHP (archivo Servidor.php)


Visualización en el navegador


Explicación del código


1) Creación del objeto XMLHttpRequest: El primer paso en nuestra aplicación era crear el objeto XMLHttpRequest.


2) Preparación de la petición: El siguiente paso es preparar el objeto para la realización de la petición, operación que se realiza por medio del método open().

El método open() se encuentra sobrecargado, lo que significa que tiene 4 versiones, teniendo la en la última versión la más completa la cual contempla 5 parámetros.


3) Función de retrollamada: Cuando la petición que se realiza al servidor es de modo asíncrono, es necesario indicarle al objeto XMLHttpRequest que función se debe encargarse del procesamiento de la respuesta cuando ésta esté disponible en el cliente. 

La propiedad onreadystatechange es la responsable de la tarea mencionada anteriormente.


Esta propiedad es del tipo EventListener (escucha ante un evento), lo que significa que debe contener la definición de una función manejadora de evento.

El evento que genera la llamada a la función definida por onreadystatechange es el evento cambio de estado (incluida en la propiedad). Este evento se produce varias veces desde el momento en se envía la petición hasta que se recibe la respuesta en el cliente.


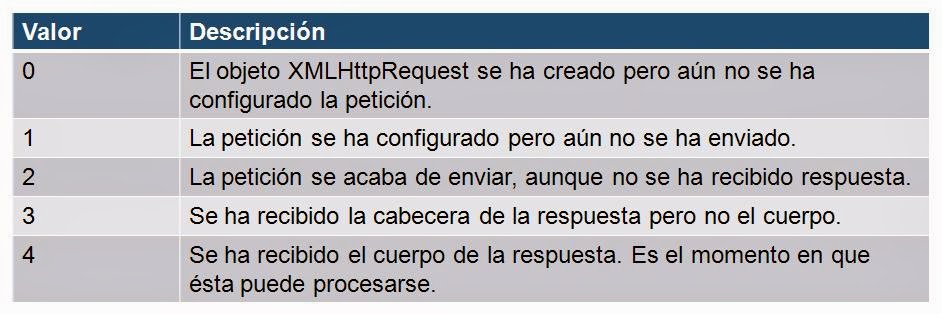
4) Estado de la petición: El evento cambio de estado se produce varias veces por lo que necesitamos una función que compruebe el estado de la petición en curso, tarea que puede realizarse consultando la propiedad de sólo lectura readyState del objeto XMLHttpRequest dentro de la función de retrollamada.


Los valores que puede tomar readyState durante el ciclo de una llamada AJAX son:


5) Envío de la petición: Una vez configurados los parámetros que afectan a la petición procederemos a su envío mediante el método send() del objeto XMLHttpRequest el cual tiene 3 versiones.


Beneficios de utilizar AJAX

  • Permite que nuestras aplicaciones Web sean más interactivas y responda mejor a las acciones del usuario. 
  • Fomenta el desarrollo de patrones que evitan que los desarrolladores no tengan que reinventar la rueda para realizar tareas rutinarias. 
  • Hace uso de tecnologías existentes. 
  • Hace uso de la habilidades de los desarrolladores. 
  • Se integra perfectamente con las funcionalidades que proporcionan los navegadores Web.

Problemas de utilizar AJAX

  • No se pueden guardar el estado de páginas con AJAX a la lista de páginas favoritas del navegador. 
  • Puede ser que los buscadores no indexen todas las partes de un sitio Web que utiliza AJAX. 
  • Pulsar el botón atrás de navegador no produce el mismo resultado que en una página Web clásica.
  • Si el navegador Web tiene desactivado JavaScript, inhabilita el funcionamiento de AJAX.

JQUERY
jQUERY es un biblioteca JavaScript que: 

  • Simplifica la forma de interactuar con documentos HTML. 
  • Manipula el DOM. 
  • Maneja eventos 
  • Desarrolla animaciones.
  • Agregar interacción con la técnica AJAX. 
jQuery es software libre y de código abierto y tienen muchas funcionalidades las cuales logran resultados notables en menos tiempo y espacio de código.

Características

  • Selección, interacción y modificación del DOM. 
  • Manipulación de CSS. 
  • Manipulación de eventos. 
  • Desarrollo de efectos y animaciones. 
  • Uso de la técnica AJAX. 
  • Soporta extensiones. 
  • No pesa más de 35kb (versión de producción). 
  • Funciona en múltiples navegadores. 
  • Permite crear plugins.

Instalación de JQUERY

1) Descargar jQUERY de http://jquery.com
2) Incoporar el archivo jquery-x.x.x.js en tu sitio Web como cualquier otro archivo JavaScript.


Iniciando JQUERY
Antes de proceder a realizar una acción con jQUERY debemos percatarnos que el documento esté listo. Para ello usamos $(document).ready();


Selección de elementos
Para seleccionar elementos HTML se hace de la siguiente forma


Algunos eventos JQUERY


Ejemplos

HTML + JQUERY (evento click)


Resultado


HTML + JQUERY


Resultado


AJAX en JQUERY
JQUERY trae incorporado un módulo de AJAX, el cual hace uso de los métodos GET y POST.


Ejemplo

HTML + JQUERY


Lenguaje de Servidor PHP (archivo Control.php)


Espero les haya servido mucho este post para los que recien inician en estas tecnologías les puede ser muy útil.

Hasta la próxima su amigo Carlos Z.

martes, 22 de octubre de 2013

Transacciones y Niveles de Aislamiento en MySQL

Hola a todos, está vez he decidido postear algo respecto a transacciones en MySQL, para muchos un tema conocido pero para otros no. Este post intentará despejar algunas dudas.

¿Qué es una transacción?
Son un conjunto de órdenes que se ejecutan en un sistema de gestión de base de datos (MySQL, SQL Server, Oracle, PostgreSQL) formando una unidad de trabajo (a esto se le llama atomicidad)

MySQL (SGDB) es transaccional, porque es capaz de mantener la integridad de los datos, haciendo que las transacciones no finalicen en un estado intermedio. Es por ello que se le atribuye el acrónimo ACID.

Si por alguna causa el sistema debe cancelar la transacción, empieza a deshacer las órdenes ejecutadas hasta dejar la base de datos en su estado inicial (llamado punto de integridad).

ACID:
  • Atomicidad: se entiende que una transacción no es divisible, o sea, que deben ejecutarse todas las instrucciones de una transacción como una unidad lógica de trabajo e indivisible, en caso de que alguna falle no se ejecuta ninguna. 
  • Coherencia: significa que sólo datos válidos pueden ser grabados en la base de datos. Si se ejecuta una transacción que compromete la coherencia interna de la base de datos, toda la transacción debe cancelarse. 
  • Aislamiento: las transacciones que tengan lugar simultáneamente deben ejecutarse aisladas unas de otras hasta que finalizan. 
  • Durabilidad: la garantía de que una transacción una vez confirmada no podrá ser desecha.

Causas posibles para que una transacción falle.
  • Falla del hardware o software.
  • Alta concurrencia a una base de datos.
  • Algunas ejecuciones paralelas pueden intercalarse de manera que pueden dejar a la base de datos en un estado inconsistente.
  • Falla del sistemas operativo.
  • Falla de energía eléctrica.
  • Falla en el software de base de datos.
  • Etc.

NOTA: Para sacarle mayor provecho a este post debemos ver algunos conceptos importantes como son: serialización y atomicidad.


Serialización 
Antes pondré un ejemplo que nos va a ayudar a clarificar este concepto.

Ejemplo: Supongamos que en un sistema de inscripción de cursos, el curso Matemática le queda una sola vacante y dos alumnos desean llevar ese curso. Cuando los dos alumnos entran al sistema, se pueden ver los siguientes procesos:
  • El sistema buscará aquellos cursos que si puede llevar el alumno y tenga vacante disponible.
  • El alumno elige el curso Matemática.
  • El sistema asigna el curso Matemática al alumno que lo ha elegido.
Es posible que ambos alumnos hayan elegido el mismo curso y el sistema se los haya podido asignar dejando a la base de datos en un estado indeseable.

Entonces la serialización consiste en:
  1. El estado de la base de datos debe quedar como si una operación fue realizada primero y otra después (a esto se le llama ejecución serializable).
  2. Si una ejecución es serializable, nunca se le asignará a los dos alumnos el curso cuya limitante es la vacante.
  3. Se debe tener en cuenta que no se desea que un proceso se lleve uno detrás de otro, pero si se necesita que el resultado sea serializable.
Atomicidad
Colocaré un ejemplo clásico que nos ayudará a ver con mayor claridad este concepto.

Ejemplo: En una aplicación un proceso de transferir fondos entre dos cuentas A1 y A2: 
  • Verificar que A1 tenga suficiente dinero. 
  • Aumenta el saldo de A2. 
  • Disminuye el saldo de A1. 
Supongamos que el sistema falla antes de ejecutar la tercera tarea, lo que genera que la base de datos se encuentre en un estado indeseable.

Entonces la atomicidad consiste en que que todas las operaciones se ejecuten o que ninguna lo haga.

Pregunta: --> ¿El uso de transacciones resuelve los problemas de atomicidad y serialización?

Rpta: "SI", porque una transacción está compuesta por un grupo de instrucciones SQL que se ejecutan atómicamente (se ejecutan todas o ninguna de ellas) y además se les exige ejecuciones serializables.

Partes de una transacción
  1. Toda transacción comienza con la sentencia begin. Esta sentencia indica a la base de datos que se prepare porque vienen un conjuntos de instrucciones SQL que la modificaran.
  2. Ejecución y validación del conjunto de sentencias SQL que modificarán la base de datos.
  3. Aquí existen dos posibilidades
    • Si todo estuvo OK, entonces se debe ejecutar la instrucción commit la cual hace que la transacción termine de forma exitosa y hace permanente cualquier cambio realizado sobre la base de datos.
    • Si hubo algún problema, entonces se debe ejecutar la instrucción rollback la cual aborta la transacción y la hace terminar en forma no exitosa, cualquier cambio que la transacción pudo hacer a la BD se deshace.
Del ejemplo de transferencia de fondos entre cuenta entonces debería quedar algo así:
  1. begin
  2. La cuenta A1 no tiene suficientes fondos --> rollback
  3. Se aumenta el saldo de A2 al monto especificado.
  4. Se disminuye el saldo de A1 en el monto especificado.
  5. commit

Niveles de aislamiento en transacciones
SQL permite definir diferentes ciertos niveles de aislamiento para el tratamiento de las transacciones.
  • Serializable.
  • Read Commited.
  • Repeatable Read
  • Read Uncommited.
Para explicarlo mejor, nos basaremos de un ejemplo:

Ejemplo: 

  • El bar de Pepe vende dos tipos de cerveza Cristal y Pilsen a S/3.5 y S/4.0 respectivamente. 
  • Juan hace una consulta sobre la cerveza más barata y sobre la cerveza más cara.
  • Pepe al mismo tiempo que Juan hace la consulta modifica la base de datos, eliminando ambas marcas de cerveza pero ingresando una nueva marca Kunstman a S/5.0
  • Juan ejecuta las siguientes consultas

  • A estas consultas les llamaremos (max) y (min) respectivamente.
  • Por su parte Pepe ejecuta

  • A estas consultas les llamaremos (del) e (ins) respectivamente.
  • Supongamos que ambas consultas se ejecutan simultáneamente en la base de datos.
  • Lo único que podemos asegurar es que (max) se ejecutó antes que (min) y que (del) se ejecuto antes que (ins)
  • Muestro una imagen de una posible ejecución


  • Juan lee que el precio máximo es de la cerveza Pilsen a S/ 4.0 y lee como mínimo el precio de Kunstman a S/ 5.0


Nivel Serializable
Si Juan ejecuta sus instrucciones con una base de datos MySQL con un nivel de aislamiento serializable, entonces la base de datos responderá con datos antes o después de la ejecución de las instrucciones de Pepe pero nunca en el medio. Por lo tanto con esto nos aseguramos que un grupo de instrucciones se ejecuten antes y otro después.


Se le consideran como el nivel máximo de aislamiento y también genera el máximo nivel de bloqueos.


Nivel Read Commited (lecturas confirmadas)
Este nivel de aislamiento evita la lectura sucia de datos. Este nivel hace que SGBD lea y devuelva información que ha sido confirmada. 

Por ejemplo, Pepe ejecuta (del) e (ins) pero luego lo piensa, se arrepiente y hace rollback para deshacer los cambios.

Si Juan ejecuta su consulta después del (ins) y antes del rollback.


Juan lee el precio S/5.0 como máximo y mínimo, sin embargo S/5.0 es un dato que nunca existirá (lectura sucia). Este nivel evita este tipo de lecturas ya que nunca fue confirmada
Los problemas de este nivel son:
  • Lecturas no repetibles: dos sentencias SELECT iguales y consecutivas podrían devolver datos diferentes.
  • Datos fantasma: dos sentencias SELECT iguales y consecutivas podrían aparecer y desaparecer filas.
Otra posibilidad de lectura sucia es que si Pepe hace commit, Juan lea como máximo S/4.5 y como mínimo S/5.0 si las consultas se realizan de la siguiente forma.


Nivel Repeatable Read (lectura repetible)
Este nivel de aislamiento garantiza que dos consultas consecutivas diferentes dentro de una transacción devolverán información consistente.

Supongamos que Juan ejecuta sus consultas sobre una base de datos MySQL con nivel de aislamiento Repeatable Read y el orden de sus consultas es:


Durante las lecturas (max), Juan leyó S/3.5 y S/4.0, el SGBD debe asegurar que durante (min) se vean adicionalmente a S/5.0, los valores de S/3.5 y S/4.0 ya que estos fueron vistos en la lectura anterior, por lo que Juan verá datos consistentes: máximo precio es S/4.0 y el mínimo es S/3.5 aunque esto no refleje el estado actual de la base de datos.

El problema de este nivel son los datos fantasma: dos sentencias SELECT iguales y consecutivas podrían aparecer datos diferentes. 

Por ejemplo Juan intenta leer dos veces el precio máximo (max).


Si la consulta es ejecutada cuando la base de datos se encuentra con el nivel de aislamiento repeatable read se asegura que todo lo que lee en el primer (max) lo lee también en el segundo (max), sin embargo en un caso obtiene que el máximo es S/4.0 y luego S/5.0.


Nivel Read Uncommited (lectura no confirmada)
Este nivel es el menos aconsejable para muchas casuísticas, pero ojo no quiera decir que para otra sirva.

Los problemas de este nivel es que permite: lecturas sucias, lecturas no repetibles y lecturas fantasmas.


Espero les haya servido mucho esta entrada.


(Fuente principal: Sr. Jorge Pérez Rojas - Universidad de Talca año 2006)

jueves, 17 de octubre de 2013

HTML 5 y su estructura

Hola amigos, aquí dejándoles un nuevo aporte. Como todos saben hoy en día está de moda HTML 5 y en este nuevo POST escribiré algunos conceptos y detalles importantes a tener en cuenta de este lenguaje de etiquetas.

HTML 5
Es la quinta revisión más importante del lenguaje de etiquetas, por lo tanto es una actualización. Asimismo es considerado un termino de marketing para agrupar las nuevas tecnologías de desarrollo Web: HTML5, CSS3 y nuevas capacidades de JavaScript.
  • HTML5 se encarga de la estructura (ESTRUCTURA).
  • CSS3 se encarga de presentar la estructura (ESTILO).
  • JavaScript (FUNCIONALIDAD)

HTML 5 aún es un trabajo en progreso (tenerlo en cuenta) sin embargo, los principales navegadores (chrome, firefox, safari, opera) son compatibles con muchos de los nuevos elementos que ofrece la nueva versión.

La versión HTML 4.01, carece de características necesarias para la creación de aplicaciones modernas, como el uso de audio y vídeo es por ello que es muy común utilizar JScript y plugins como Macromedia Flash.

Nuevas funcionalidades (las mas interesantes desde mi punto de vista)
  • El elemento < canvas > para el dibujo 2D.
  • Los elementos < video > y < audio > para la reproducción de medios. 
  • Nuevos elementos para manejo de contenido y estructura. 
  • Nuevos controles de formulario.

NOTA: Este post se centrará en la estructura de un documento HTML 5.

Ahora veremos una definición interesante que muchos no toman en cuenta o quizás la conocen pero no le toman la debida importancia.

¿Qué es una página Web?

Una página Web es un documento que contiene información electrónica como: texto, imágenes, sonido, vídeo, etc. Adaptada para WWW y que puede ser accedida por un navegador Web (chrome, firefox, opera, safari)

Teniendo en cuenta la definición anterior, todo documento tiene una estructura (una carta, un memo, etc.) y las páginas Web no son la excepción ya que son documentos que contienen información electrónica.

Una buena estructura de cualquier documento ayuda al lector a visualizar todos los contenidos de una manera fácil y clara. Una mala estructura produce una sensación de estar perdido, por lo tanto el lector no encontrará rápidamente lo que busca y terminará por abandonar el sitio Web.

Como sabemos el propósito de HTML es la creación de estos documentos estructurados, páginas Web, es por eso que su versión 5 cuenta con nuevas etiquetas que ayudan a este propósito tan importante pero tan desatendido por muchos programadores del medio.

Los navegadores Web son los encargados de interpretar la estructura del documento y luego mostrar los contenidos al lector, es por ello que éstos necesitan de etiquetas más poderosas que seccionen el documento para saber donde comienzan y terminan los contenidos y cual es su cometido dentro del documento. Esto ayuda mucho a los motores de búsqueda y bases de datos al proceso de Indexación (elaboración de un índice que contenga de forma ordenada la información, esto con la finalidad de obtener resultados de forma sustancialmente más rápida y relevante al momento de realizar una búsqueda).

Un documento HTML 5 se estructura desde dos puntos de vista:
  • Una estructura global.
  • Una estructura del cuerpo.
Estructura Global: lo haré con un gráfico y eso representa la estructura global de una página Web.


Estructura del cuerpo (dentro de la etiqueta < body >)

  • Cabecera < header>: esta sección provee de información introductoria como: logo, título, subtítulos, y una corta descripción del sitio web. Difiere con respecto a la etiqueta porque ésta refiere información de todo el documento. 
  • Barra de navegación < nav >: es la sección que por lo general se ofrece un menú con el propósito de facilitar la navegación sobre el sitio Web.
  • Información principal < section >
    :
    Contiene la información más relevante del documento. Podría contener una lista de productos, descripciones varias, noticias,o cualquier otra información importante para esa sección del sitio Web.
  • Barra lateral < aside >esta sección contiene datos relacionados con la información principal pero que no son igual de importantes. Podrían ubicarse del lado derecho o izquierdo de nuestro sitio Web. 
  • Institucional < footer >: esta es el área donde normalmente se muestra información del sitio Web como: el autor, la empresa, enlaces con los términos y condiciones y toda información adicional que se considere importante compartir.
Coloco una imagen copiada de un sitio Web que me gustó mucho.


Espero les haya servido esta información.

Hasta la próxima su amigo Carlos Z.

Seguidores